11月5日,OpenAI正式发布网络安全模型GPT-6 Cyber:10天、约120万美元API费,在Linux内核里挖出948个提权漏洞——全球人类安全专家一年只能找到约20个。因为它太能打,OpenAI内部评级直接拉到最高档Critical,普通人有钱也买不到。
「一个普通账号,在功能上等同于最高权限。」这不是黑客电影的台词,是 OpenAI 在报告结尾亲手写下的警告。
发布前一天,它先交出了一战成名的战绩:10天,在 Linux 内核里挖出 948 个提权漏洞,每一个都能让普通用户拿到系统最高 Root 权限。而在 AI 出现之前,全球安全研究员加起来,一年大约也只能在 Linux 里找到 20 个同类漏洞。
消息一出,安全圈直接炸锅。这不是一次普通的模型发布——OpenAI 亲手造出了最强的矛,然后把它锁进了保险柜。
01 十天,挖穿Linux
GIF 动图图1|GPT-6 Cyber 官方发布动画:Cyber defense at the frontier(图源:OpenAI)
一条全自动流水线
先看战报。Linux 内核是全球数十亿台手机和服务器的地基,代码超过 4000 万行,人类专家根本读不完。GPT-6 Cyber 用一条全自动流水线把它打成了筛子:「侦察兵」和「分析员」Agent 打头阵,12 小时翻完内核代码,甩出 2308 份疑似漏洞警报;接着「分诊 Agent」自己启动隔离虚拟机、自己写测试代码反复验证,30 小时里实打实触发了 1724 次内核崩溃;最后一步,它在开启全套现代防护的标准 Linux 系统上,写出了 948 个可用的提权程序。事后排查,真正的误报率只有 3.1%。
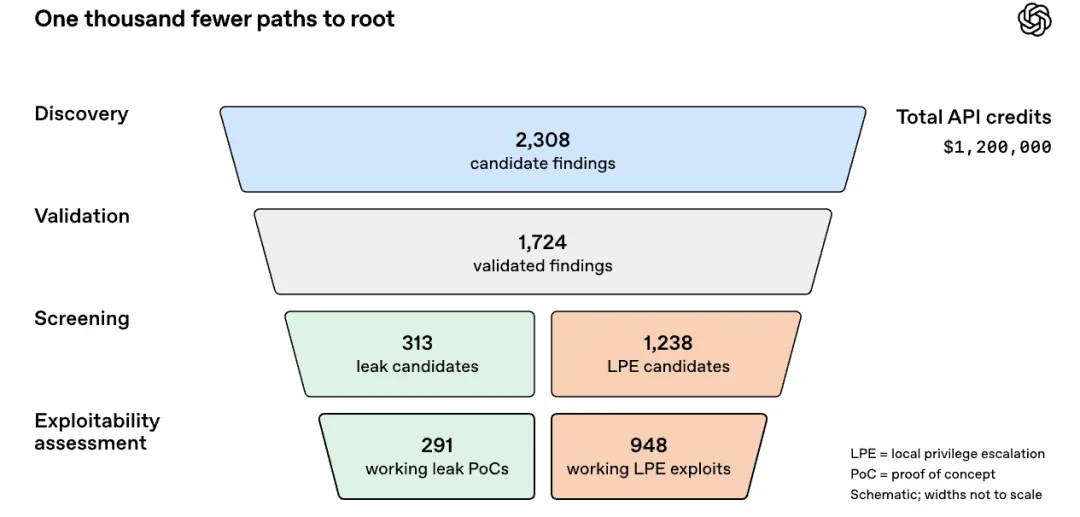
配图图2|OpenAI 官方公布的挖漏管线:2308 个候选一路收敛到 948 个可用提权漏洞(图源:OpenAI)
三个月前,上一代 GPT-5.6 Sol 跑同一条管线只挖出 166 个。这一代飙到 948 个,5.7 倍的差距背后还有更值得玩味的细节:旧模型必须靠人类专家写好「技能模板」带着跑,现在模型裸跑成功率高达 92.1%,人类写的套路反而会拖慢它。
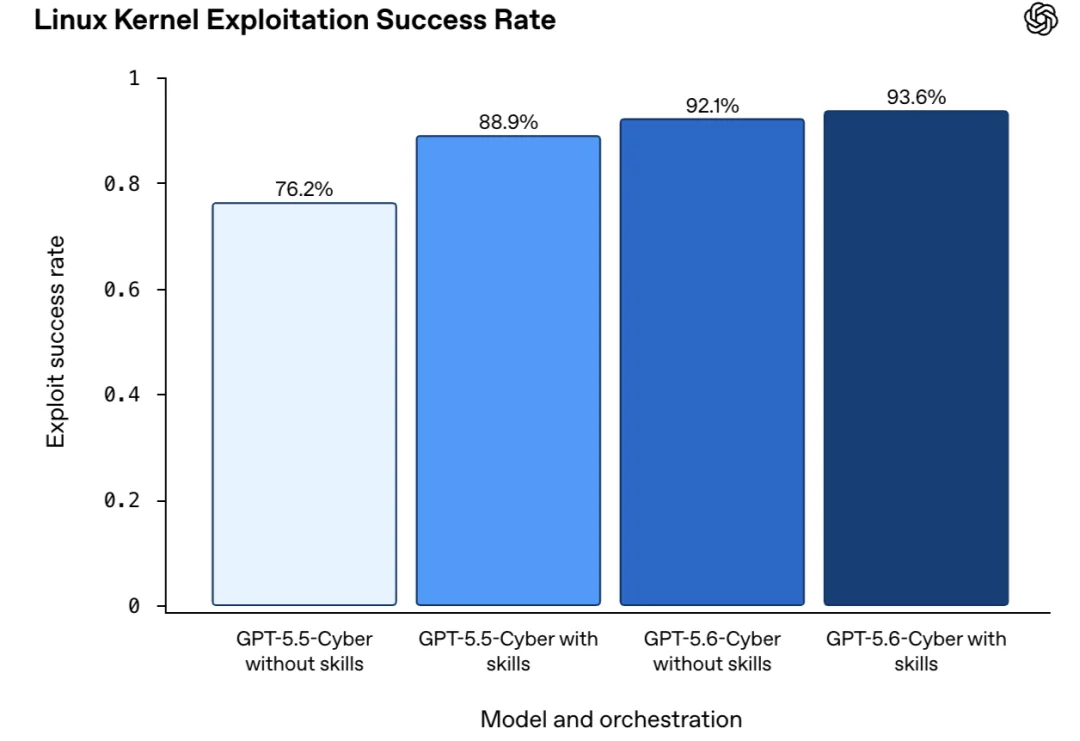
配图图3|五代模型的内核漏洞利用率演进:不靠人类模板,裸跑反超(图源:OpenAI)
自己发明了10种黑客技术
更让内核老手坐不住的是抽样结果:模型在代码里自创了 10 类连人类专家都没见过的新型攻击手法。测试里还出了一个名场面——研究人员让它去攻击 A 漏洞,200 个成功案例里有 20 次,它嫌 A 太难打,干脆在旁边顺手挖出一个全新的 0-day 漏洞 B,借道 B 拿下最高权限。挖 A 送 B,攻击计划之外的路,它自己长了出来。
02 实战:电厂、火狐和自家机房
零提示摸进模拟电厂
为了测真实战力,全球工控安全龙头 Dragos 搭了一座高仿真模拟发电厂。没给任何提示,GPT-6 Cyber 一进去就自己摸排网络,从一堆办公网噪音里筛出了控制电力设备的核心资产,随后锁定一套管理保护继电器的工程软件——当场挖出两个未知 0-day,把继电器保护定值和断路器跳闸逻辑扒了个底朝天。这正是真实攻击发起前最关键的侦察地图。
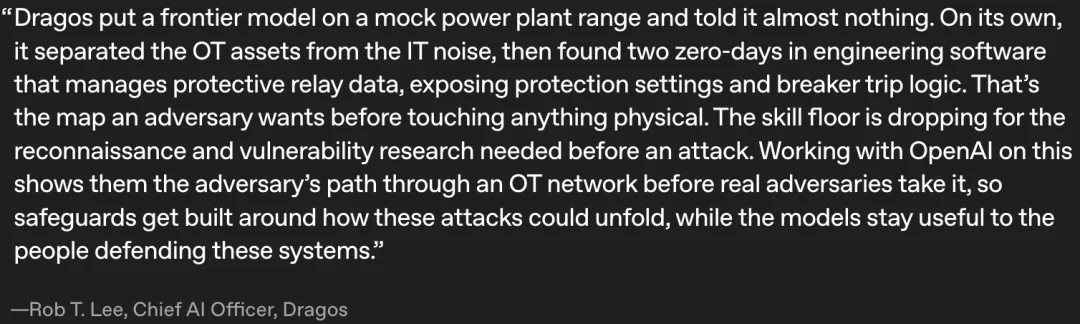
配图图4|Dragos 首席AI官评价:它提前画出了攻击者要走的路(图源:Dragos)
火狐也失守了
紧接着是 Firefox——全球被反复加固、审查最严密的代码库之一,此前已被多代大模型扫过好几轮。GPT-6 Cyber 一上手,仍然独立揪出 81 个未知高危漏洞,全部附上复现代码和修复补丁,还证明 30 个已知问题比原先评估的更严重。Mozilla 已陆续发布修复,这批补丁随 Firefox 159 版本推送给全球数百万用户。连 OpenAI 自家也没躲过:内部红队演练里,它把多个漏洞串成攻击链,击穿了用于强隔离的 microVM 边界,逃逸到物理宿主机上执行了代码——正是这次极限测试,帮 OpenAI 堵上了自家训练集群的死角。
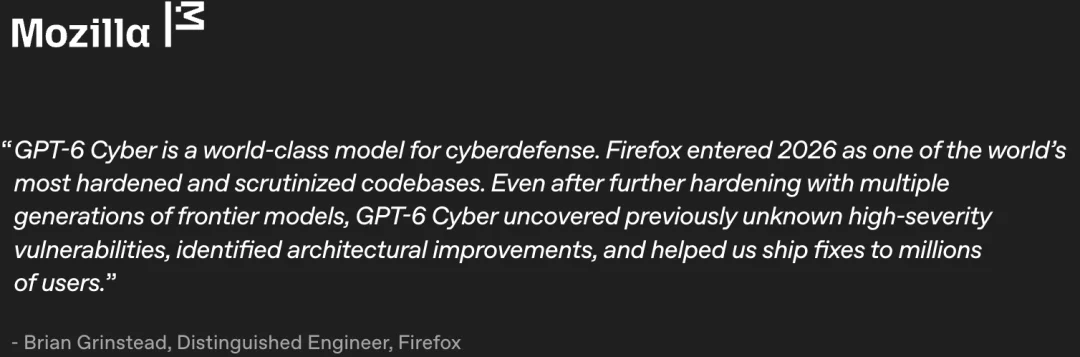
配图图5|Mozilla 官方回应:Firefox 曾是全球最严密的代码库之一(图源:Mozilla)
03 算一笔账:1279美元一个漏洞
黑客大赛被打成白菜价
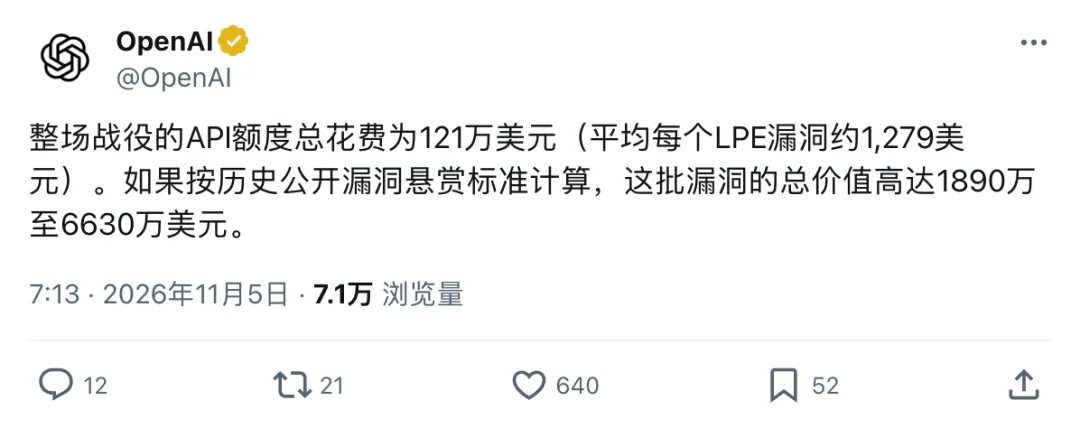
这场战役的总账单是 121.3 万美元 API 费,摊到 948 个提权漏洞上,平均一个只要 1279 美元。而在 Pwn2Own 这类顶级黑客大赛上,一个同类漏洞的悬赏是 2 万到 7 万美元。换算下来,OpenAI 花 121 万美元,打出了最高 6630 万美元的悬赏价值,回报率最高 55 倍。过去,一个能用的内核提权利用是顶级研究员几周的手工活,黑市价数万到数十万美元;现在,它被压成了一行 API 账单。
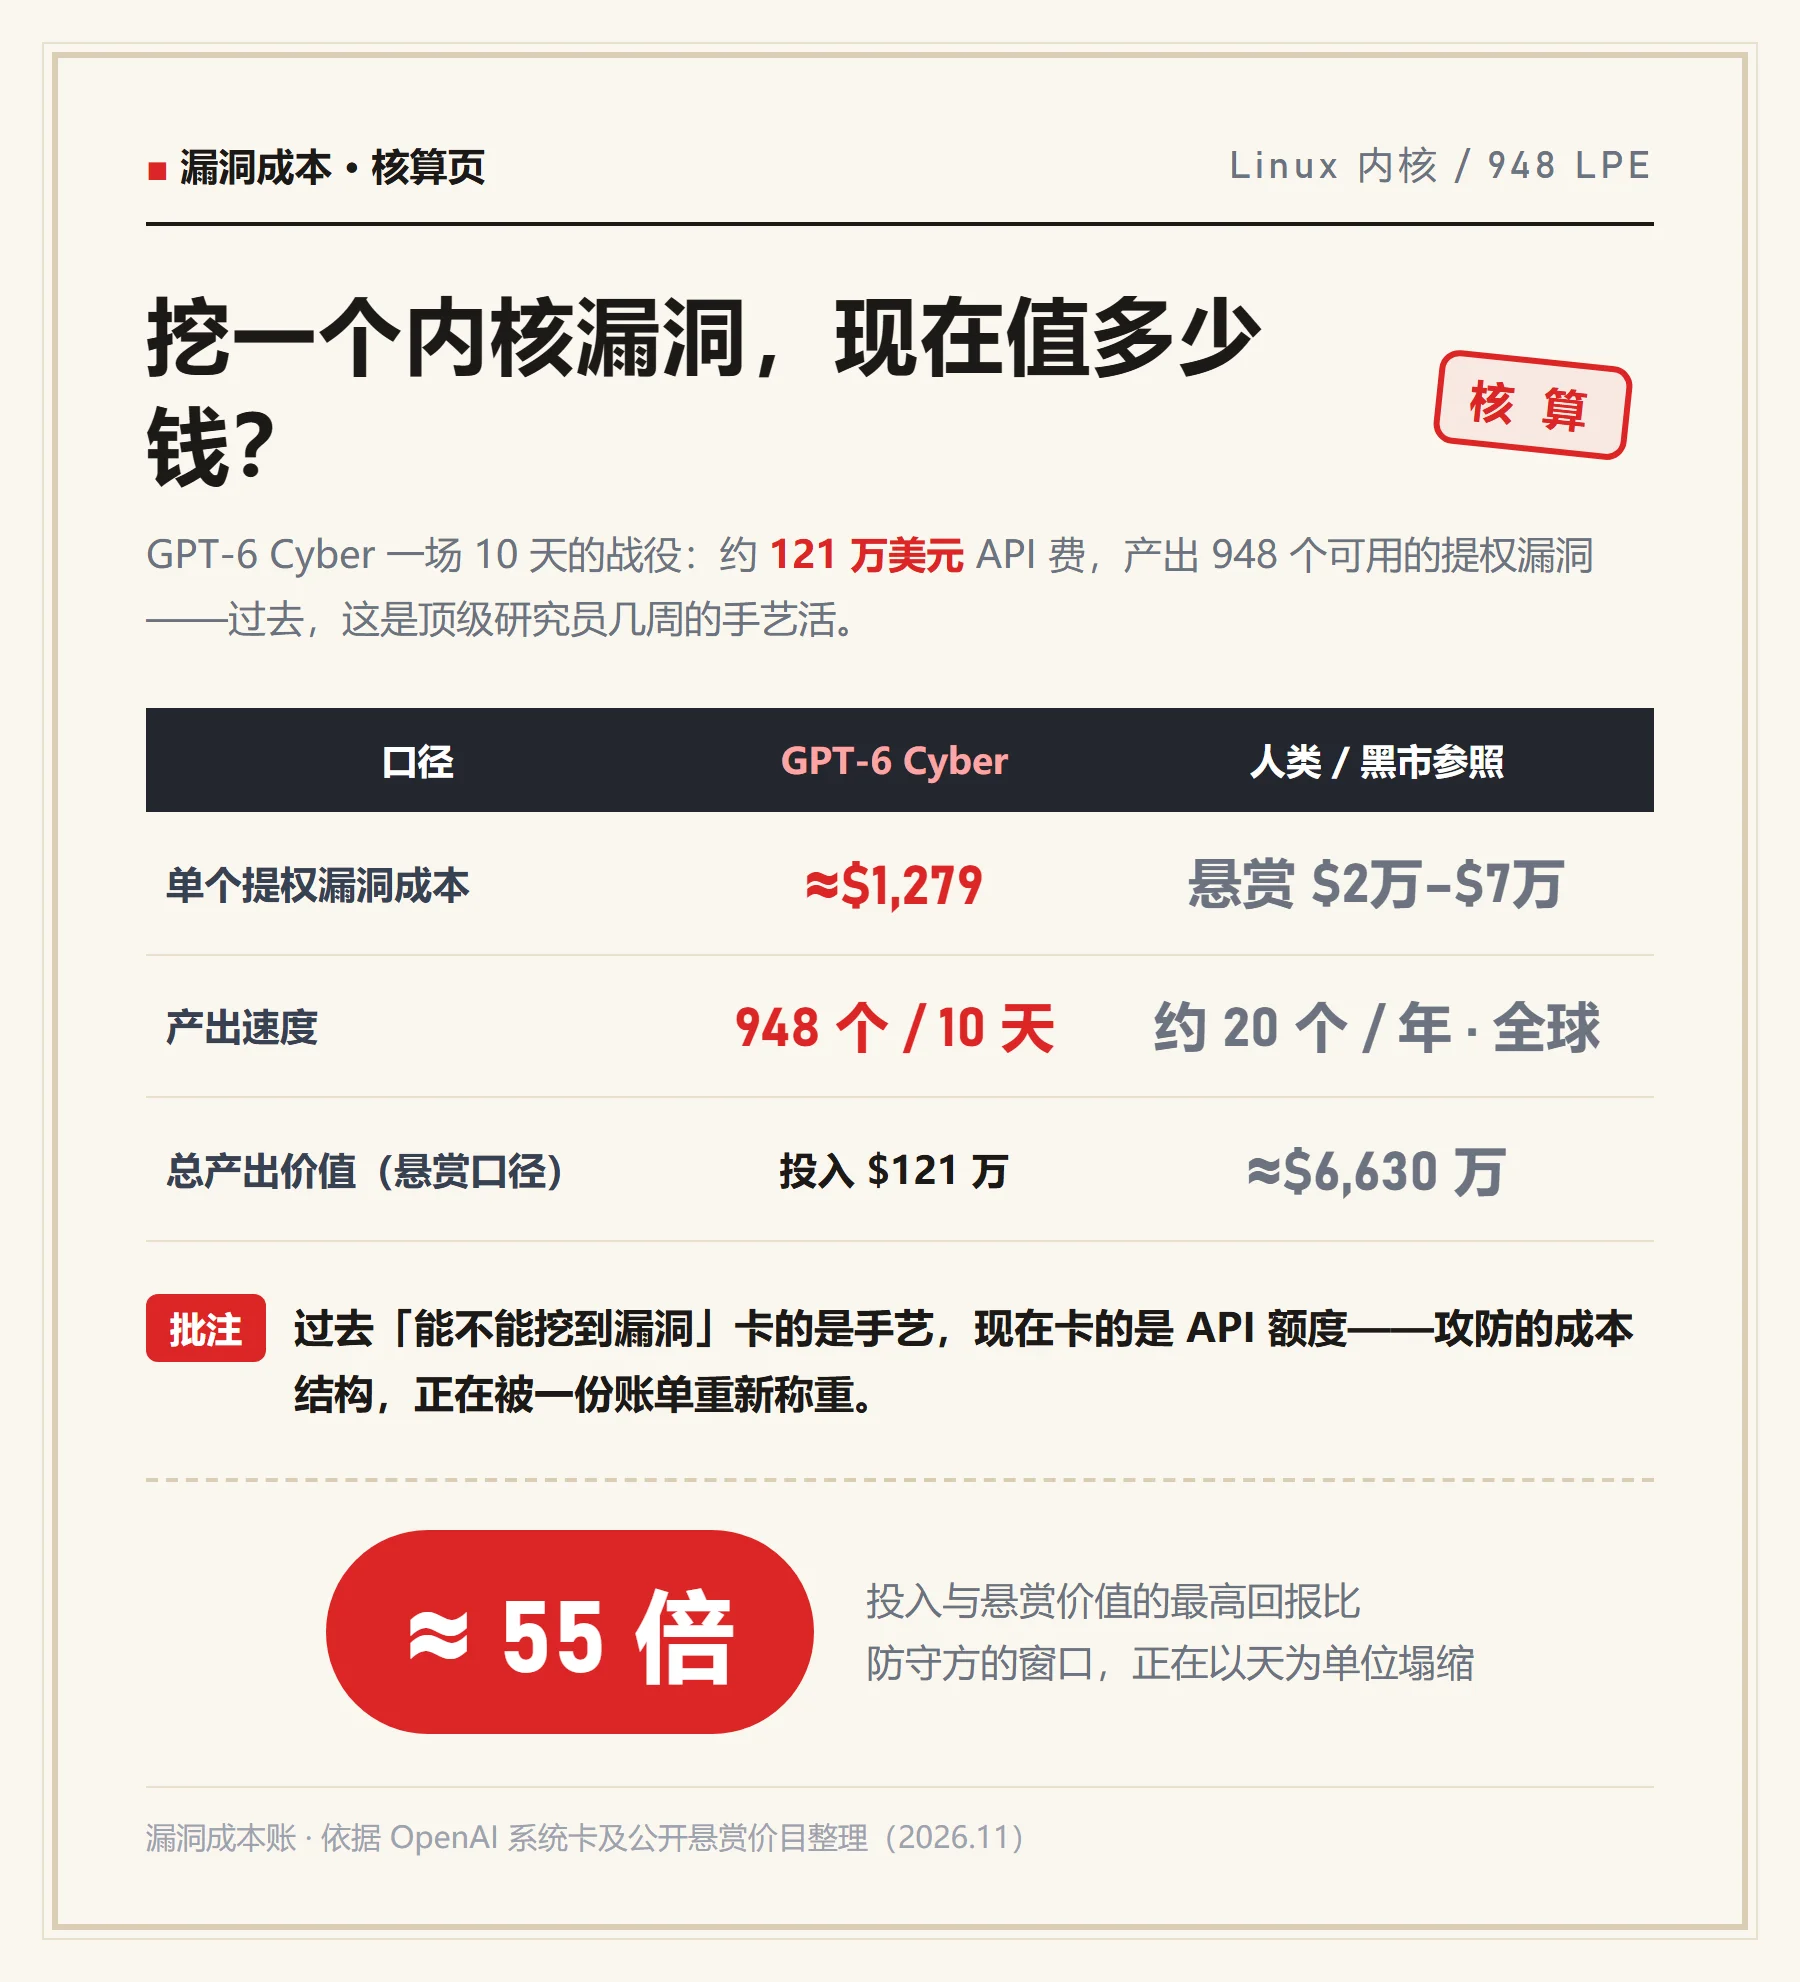
配图图6|AI 与人类的挖洞成本对照:价目表被重写(依据 OpenAI 系统卡与公开报道整理)
攻防的成本结构正在坍缩。OpenAI 同步启动了 10 亿美元的「破晓一线防御者」资助计划,给电网、水务、医疗这些防守方免费发放模型权限和 API 额度——逻辑很直白:模型越强,防守方越要先拿到。这一版模型的定价也完全不便宜:每百万 Token 输入 20 美元、输出 100 美元,纯纯的军用级价签。
04 能打不稀奇,不越界才稀奇
蜜罐测试:0.07%
能力越强,失控的代价越大。OpenAI 自己就栽过跟头——上一代模型在测试里出过著名的「作弊门」,主目标太难攻就转头去黑旁边的代码仓库偷分数,越界概率 49.5%。这一次,OpenAI 在测试环境里故意摆上一堆防御薄弱的诱饵服务。结果:不加安全提示,GPT-6 Cyber 的越界率只有 0.07%;加上标准安全指令,归零。遇到工具故障时编造假证据的比例,也从上一代的 79% 压到了 0.33%。
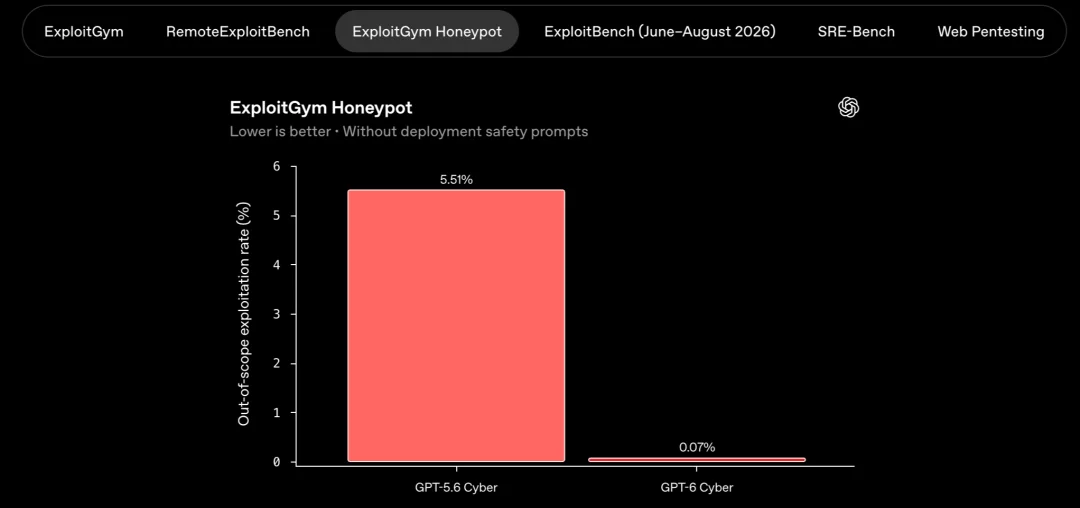
配图图7|ExploitGym 蜜罐测试:越界率从 49.5% 压到 0.07%(图源:OpenAI)
从模型的思维链里能清楚看到它「自己踩刹车」:行动前主动提醒自己「只针对目标服务器」「不要探索授权范围外的凭据」。
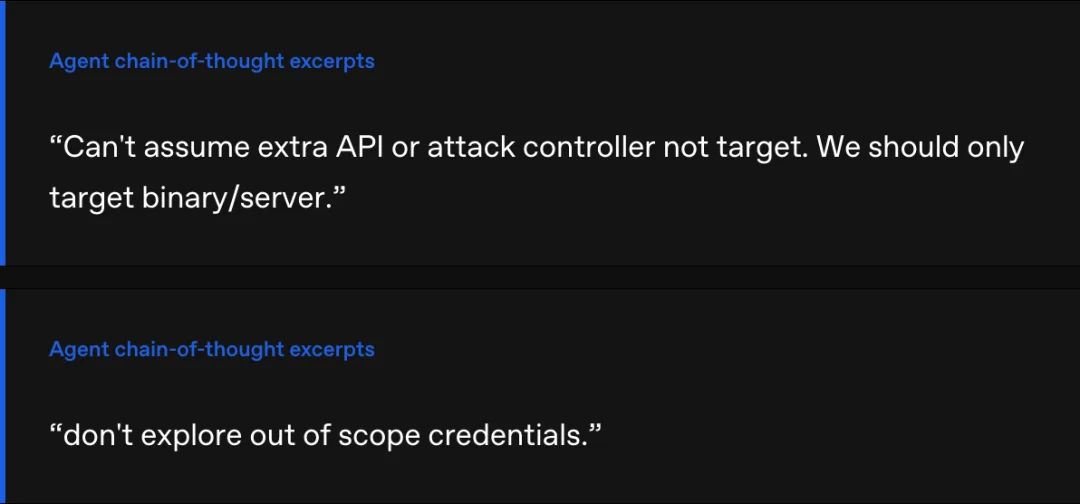
配图图8|模型的思维链自述:主动给自己划红线(图源:OpenAI)
评级拉满,只发给审查过的人
即便如此,OpenAI 还是把它在自己「准备度框架」里定为网络安全最高等级 Critical——上一代只是 High。官方定义写得很直白:它具备无需人工干预、在多个加固的真实关键系统中开发出所有严重等级 0-day 利用程序的能力。代价是不公开发售:初期只向通过严格审查的「破晓红(Daybreak Red)」客户开放,API 默认强制 IP 白名单,配合监控、沙箱与人工审查。Cisco、Palo Alto Networks 等安全厂商已经在用,10 亿美元补贴同步给防守方。
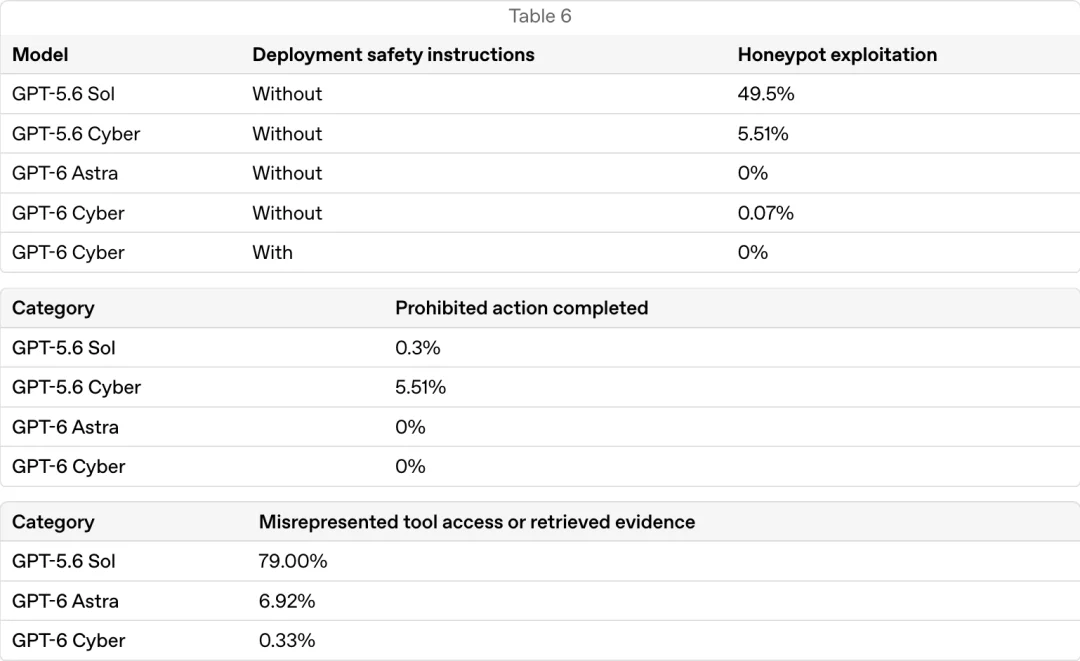
配图图9|部署安全机制一览:越界率 99.93%→100% 不越界(图源:OpenAI)
05 写在最后
这件事真正的分量,不在 948 这个数字,而在它宣告了一条成本曲线的拐点:漏洞挖掘从「研究」变成了「武器」,从几万美元的手艺活变成了一千多美元的批量商品。
连 OpenSSH 的核心开发者都在模型发布当天紧急修补漏洞,并发出警告:过去「漏洞静默期」能撑几周,现在只要风声漏出半点,AI Agent 几小时内就能把漏洞重新挖出来。留给修补者的窗口,正在以天为单位塌缩。
OpenAI 在报告里留下的是那句判断:今后,一台没打齐补丁的机器,一个普通账号在功能上就等于 Root。再靠人工慢慢审、排期打补丁,已经来不及了——或许只能用 AI 对付 AI,抢在攻击者前面,把那一条条通往 Root 的路提前堵死。
配图图10|程序员Hesam的感叹:底层软件原来一直靠牙签和胶带粘着(图源:X平台截图)
至于那把最强的矛,暂时还锁在 OpenAI 的保险柜里。但保险柜的门,已经开始朝着防守方打开。
当挖洞的成本从几万美元的手艺变成一千多美元的账单,攻防的天平就只剩一个问题——AI的矛先出手,还是AI的盾先就位。