摇臂、轨道、稳定器,电影里一个环绕主角的镜头,片场要动用一整套设备。11 月 4 日,小米技术官方宣布 WorldCast 3D 运镜功能上线 REDMI K100,相册里选一张照片,AI 就能让镜头绕着主角转一圈,五官、发型、衣着全程不崩。支撑这个功能的论文 10 月 23 日挂在 arXiv,代码和模型权重已经全部开源。
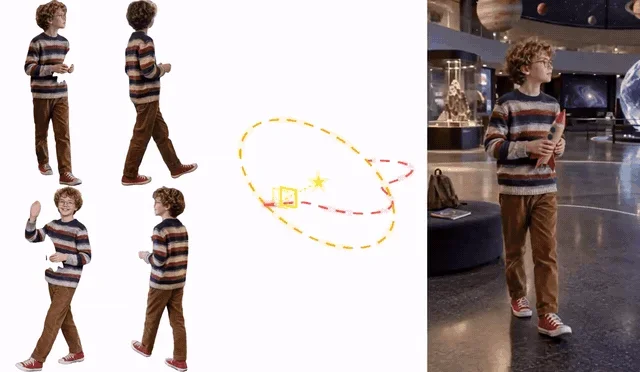
— 左侧是多视角锚点图,中间是虚拟相机轨迹,右侧是生成的运镜视频(GIF 动图,截自 WorldCast 项目主页)
一张照片,镜头替你绕一圈
10 月 27 日,REDMI K100 正式发布。8 天后的 11 月 4 日,小米技术官方发文介绍这款手机影像里的新玩法 3D 运镜。打开相册,选一张静态照片,AI 就能生成一段大角度运镜视频,镜头可以环绕、推拉、倾斜,画面里的人不会因为视角变化而变形。
这件事的门槛在片场里很高。环绕镜头要求摄影机绕着主角平稳走完一整段弧线,转到侧后方时,主角的侧脸、后背进入画面,这些区域在开场镜头里从未出现过,全靠现场的服装、道具和灯光维持形象。WorldCast 做的事情,是把这条弧线搬进算法,用一张照片虚拟出整段拍摄过程。
让 AI 按指定运镜出视频,学术圈这几年已经卷出了不少方案,CameraCtrl、ViewCrafter、Uni3C 都在这个方向上。它们大多停在论文和演示页里,这次的区别是落进了量产手机。小米把 3D 运镜放进一套更大的 AI 影像玩法矩阵,它和一键动图、希区柯克变焦、延时摄影排在同一层。对普通用户来说,这是一次点击就能触发的功能;对行业来说,这是大角度相机控制的生成框架第一次跑进端侧产品。
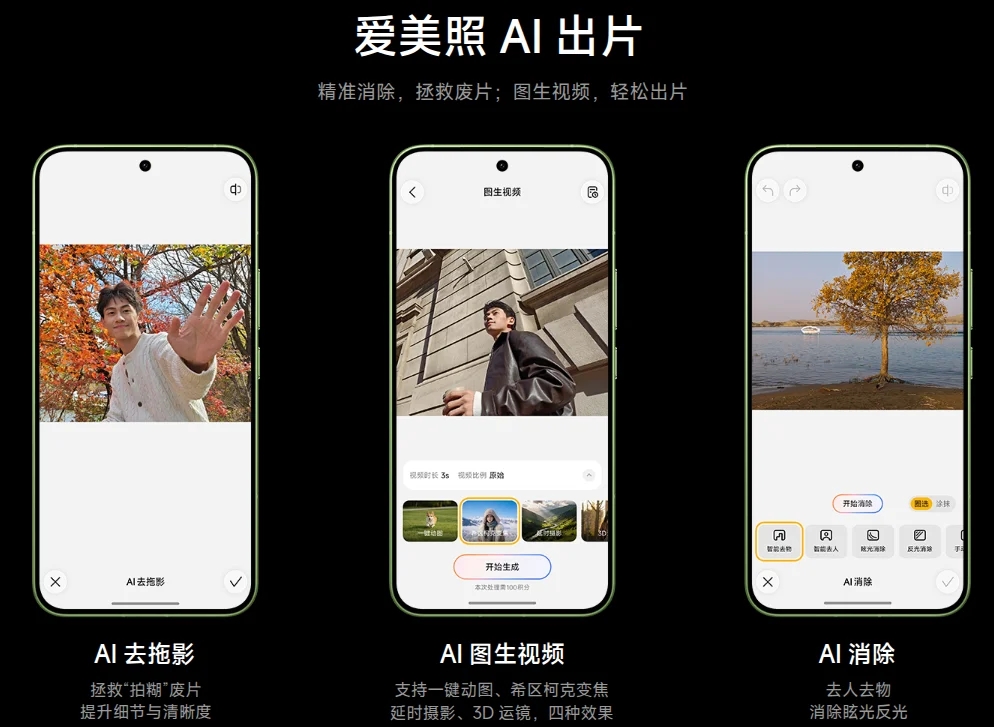
— REDMI K100 的 AI 出片功能矩阵,3D 运镜与一键动图、希区柯克变焦、延时摄影并列(截自小米技术官方公众号)
镜头转过去,人就崩了
让 AI 沿指定轨迹生成视频,业内已有不少方案。角度一大、轨迹一复杂,两个问题就会一起冒出来。
第一个是轨迹跟不住。旋转、平移、半径变化组合在一起,再叠加任意起始方位,几何条件稍有偏差,画面就会出现转不到位、平移错位、逐渐偏离预定轨迹的情况。WorldCast 论文里测的轨迹族横跨 30 度到 360 度,包括环绕、倾斜、推拉、双纽线、拉远,难度比常见的单方向运镜高出一截。用户看到的体验是生成的视频和想要的运镜对不上,只能反复重试。
第二个是身份漂移。视角一大,初始帧里没拍到的区域会被逐步揭开,侧脸、后背、脑后的发丝,这些区域的几何和外观没有任何观测约束,生成模型很容易自由发挥。结果就是越转五官越变形,衣服花纹消失,转着转着成了另一个人。
这两个问题还会互相牵制。镜头转得越远,可参考的真实信息越少,身份漂移的风险就越高。用单张照片做相机控制的方案,等于让模型凭想象补全没见过的那一面,补对了是生成,补错了就是换脸。手机端的 3D 运镜长期停在演示阶段,卡的就是这里。
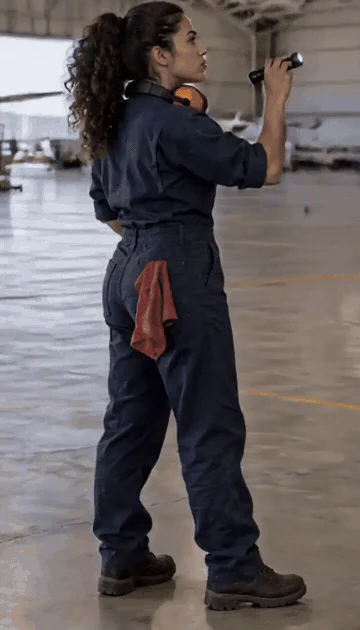
— WorldCast 生成的 360 度环绕视频,镜头绕到背面再转回正面,人物形象保持稳定(GIF 动图,截自 WorldCast 项目主页)
先搭骨架,再补记忆
WorldCast 的整体思路分三步,用显式几何搭骨架,用多视角记忆补细节,用自建数据集定标尺。
第一步是几何引导。模型先用预训练的深度估计网络读出照片的深度信息,把二维像素反投影成带颜色的 3D 点云,再沿目标相机轨迹渲染出每个视角的引导图。这一步有个关键设计叫尺度对齐,单目深度只有相对值,和相机平移的真实尺度天然对不上,WorldCast 会枚举候选尺度,分别渲染并比对图像运动量,选出最吻合的一个。点云渲染并非处处有效,被遮挡的区域没有几何支撑,框架会同时输出覆盖掩码,明确告诉生成模型哪些像素点云撑得住、哪些必须由 AI 补全。目标相机的几何被编码成 Plücker 射线,和引导图一起注入扩散模型,为每一帧提供显式的空间约束。
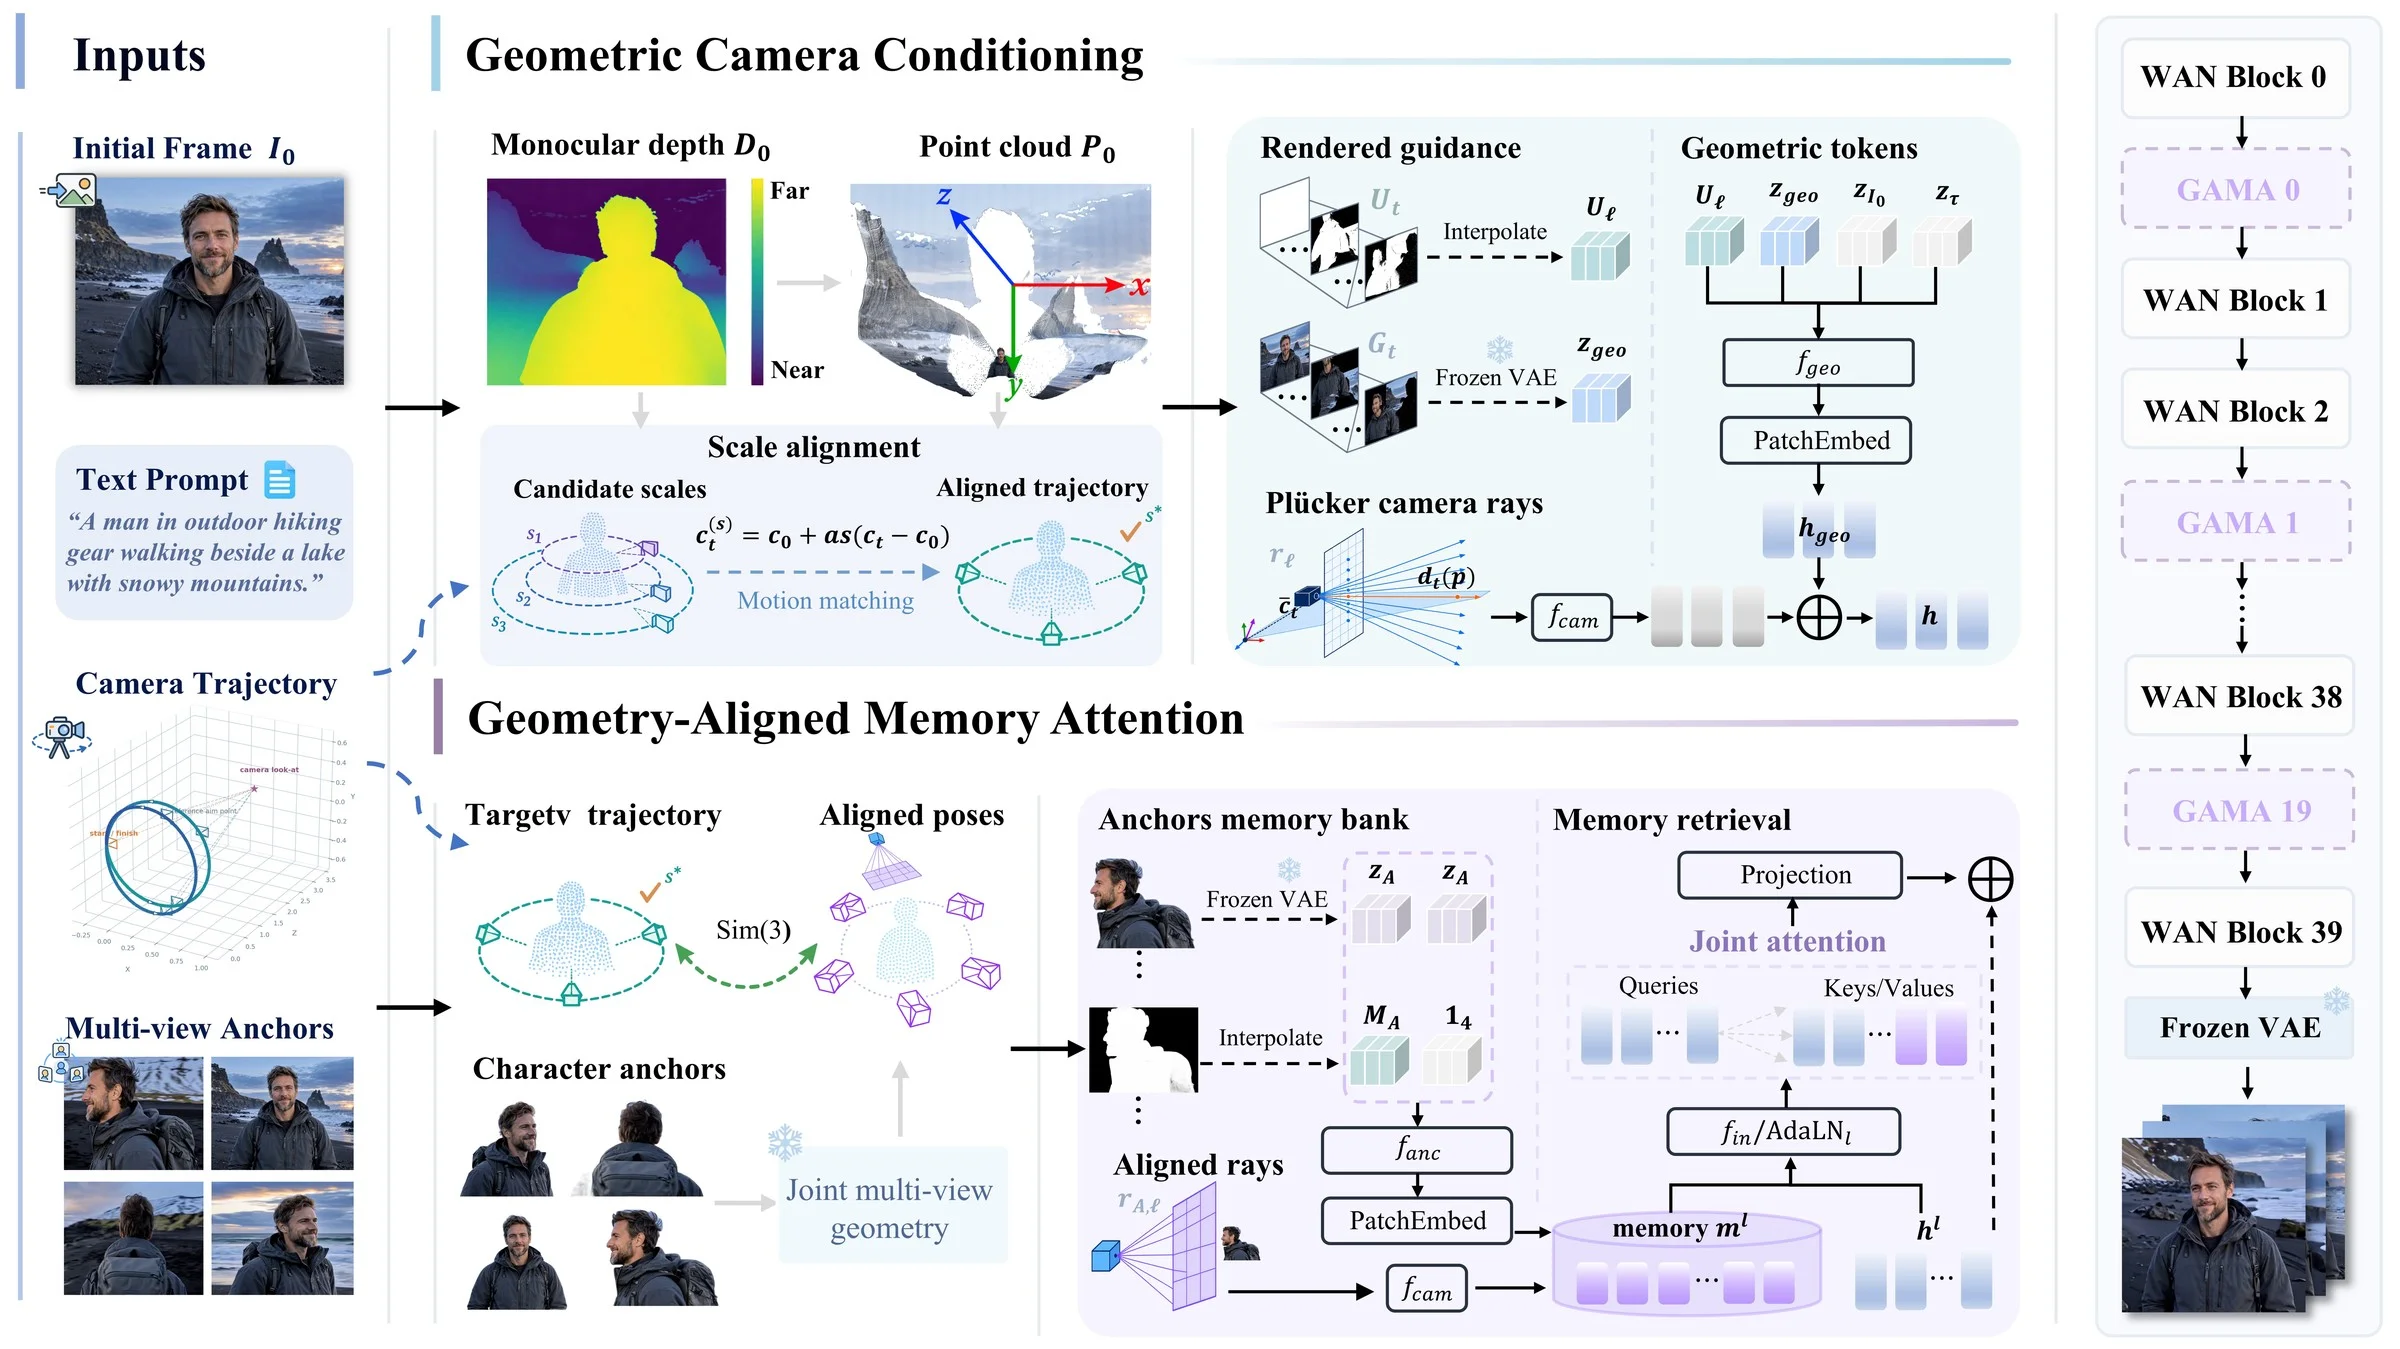
— WorldCast 框架总览,上半部分是轨迹对齐的几何引导,下半部分是几何对齐的多视角角色记忆 GAMA(截自 WorldCast 论文)
第二步是 GAMA,全名几何对齐的记忆注意力。骨架解决不了背面长什么样,这部分信息要靠同一角色的多视角锚点图来补。框架先分割出角色前景,再用多视角几何模型对初始帧和全部锚点做联合相机位姿估计,然后以初始帧为桥梁,用 Umeyama 对齐把锚点视角和目标轨迹放进同一个坐标系。生成时,镜头转到左脸就调取左脸的证据,转到背后就调取背后的证据。工程上,GAMA 以记忆注意力块的形式插在 WAN 视频生成骨干的 40 个 Transformer 块之间,一共 20 个,残差连接零初始化,训练开始时不扰动预训练权重。身份不靠模型猜,靠几何查询。
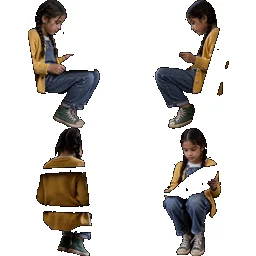
— 多视角锚点图示例,同一角色的正面、侧面、背面观察(截自 WorldCast 项目主页)
几何对齐这一步不是白做的。论文里测了注意力路由的准确率,以 21 帧为单位统计被正确路由到锚点证据的帧数,不做对齐时,整个去噪过程只从 8.7 涨到 12.7 就掉头往下走;做完对齐,这个数字一路涨到 17.3。路由准了,背面和侧面的证据才会在正确的时刻参与生成。
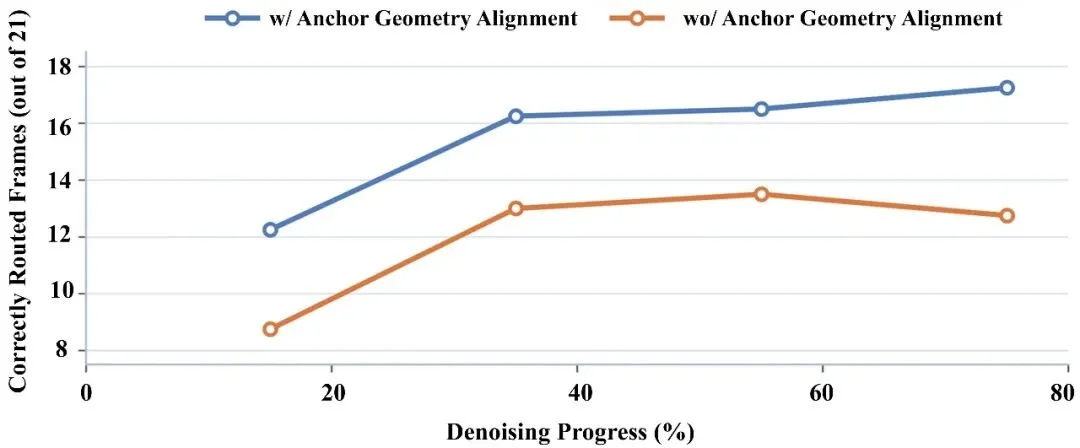
— 有无锚点几何对齐的注意力路由准确率对比,蓝线为对齐后,橙线为对齐前(截自小米技术官方公众号)
第三步是数据与评测。团队构建了角色中心的数据集 CLACT,训练集包含 80000 条样本,其中 50000 条由 Unreal Engine 5 渲染、30000 条由 Blender 渲染,覆盖 99 个角色、33 个环境、96 种动作。评测集覆盖 42 个合成与真实场景,涵盖 6 类轨迹族。运镜准不准、像不像同一个人、好不好看,第一次被放在同一把标尺上度量。
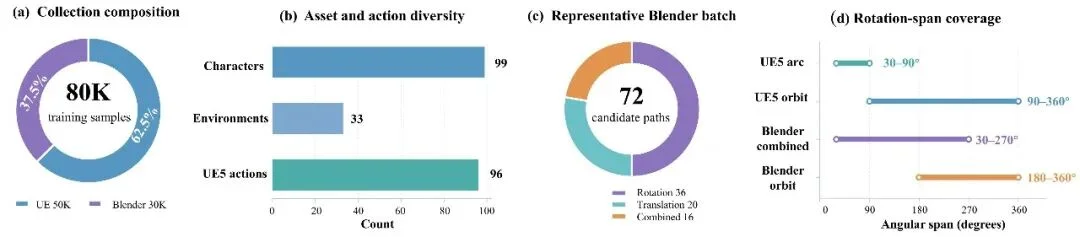
— CLACT 数据集构成,左为 UE5 与 Blender 的 8 万样本构成,右为各轨迹族的旋转角度跨度(截自小米技术官方公众号)
成绩单与冷水
在 CLACT 基准上,WorldCast 与 13 个方法同台竞技,对手横跨三类路线,Uni3C、CameraCtrl 这类相机控制生成模型,GEN3C、ViewCrafter 这类新视角生成模型,还有 ReCamMaster 这类视频重渲染模型。WorldCast 拿下全部相机控制与角色一致性指标第一。轨迹误差 ATE 从此前最优的 0.098 降到 0.065,跨视角几何一致性 MEt3R 达到全场最优的 0.228,身份相似度 ArcFace 0.555,比次优的 GEN3C(0.433)高出约 28%。
0.065
轨迹误差 ATE(原最优 0.098)
+28%
身份相似度对比次优方法
13
同台对比方法全部指标第一
消融实验显示 GAMA 几乎承担了全部收益,去掉它,ArcFace 从 0.555 掉到 0.370,ATE 从 0.065 升到 0.100。几何对齐这件事本身也有贡献,去掉锚点的几何对齐,ArcFace 会从 0.555 降到 0.547,降幅不大,但路由的收敛速度和准确率都明显变差。
— 同一输入与轨迹下 WorldCast(上)与基线方法 Uni3C(下)的生成对比(GIF 动图,截自 WorldCast 项目主页)
💡 冷水:画质只是持平。画面质量 IQ 0.719 略低于 Lyra 2.0 的 0.725,WorldCast 赢在几何和身份。
更实际的门槛在部署侧,论文模型基于 WAN 视频生成骨干,社区实测需要 48GB 以上显存才能跑起来,手机端靠的是算法蒸馏加速和端云协同,官方对此只有一句话,具体怎么切分、多少上云、生成一条要多久,都没有公开。还有一处差异,论文版要 1 到 4 张多视角锚点图才能补全背面信息,手机端却宣称单张照片直出,中间缺的那部分证据从哪来,官方没有给出答案。CLACT 数据集在项目主页标注 coming soon,评测能否被第三方复现,要等数据放出才能验证。
从堆参数到堆框架
手机影像的竞争,已经从堆参数转向堆框架。WorldCast 把方法、数据集和评测基准一起留了下来,这件事的分量不轻于 3D 运镜这个卖点。自建 CLACT 基准说明团队清楚,这类生成能力没法靠主观观感验收。武大电子信息学院和小米 MiLM Plus 的组合也值得记一笔,高校出几何功底,厂商出数据和落地,这条协作路线在 2026 年的 AI 影像赛道上会越来越多。
小米技术官方给出的路线图还包括更复杂的运镜形态、更长的连续生成,以及可控 4D 视频生成。对用户来说,判断标准很简单,拿一张背景复杂的生活照,让镜头转到大角度,看人物背面崩不崩。这个测试,REDMI K100 的用户现在就能自己做。